引言
由于CZ88公众号已经不再发布,因此这个项目就失效了
警告
纯真库仅限个人开发者或学术研究使用,不能用于商业产品。
如本篇文章旨在学习python爬虫微信公众号,如果损害了您的利益,请联系站长,予以删除。
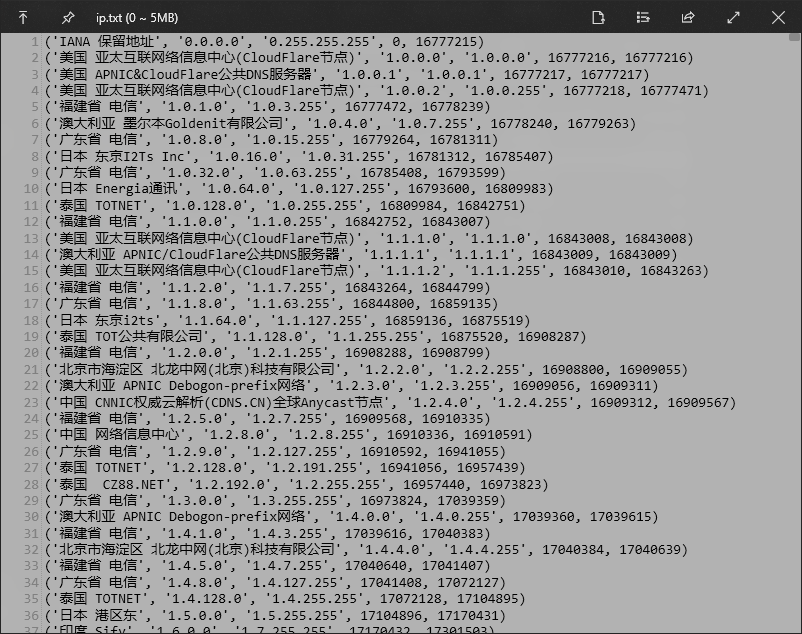
本片文章为之前写的文章的补充版,这里附上了解析操作的代码,最终结果可以自行格式化,写入数据库或者其他位置。
 cz88纯真IP库下载引言 纯真库仅限个人开发者或学术研究使用,不能用于商业产品。 如本篇文章旨在学习python爬虫微信公众号,如果损害了您的利益,请联系站长,予以…2023 年 02 月 16 日
准备工作
- python
- re
- request
- zipfile
- struct
- innoextract
innoextract.rar
代码
import struct
import socket
import requests
import re
import json
import zipfile
import os


class QQWryUtils:
    def __init__(self):
        self.packages = {}
        self.newest = '20230222'
        self.idx1 = None
        self.idx2 = None
        self.idxo = None
        self.data = None
        self.index_begin = -1
        self.index_end = -1
        self.index_count = -1
        self.__fun = None

    def __clear(self):
        self.idx1 = None
        self.idx2 = None
        self.idxo = None
        self.data = None
        self.index_begin = -1
        self.index_end = -1
        self.index_count = -1
        self.__fun = None

    def __int3(self, data, offset):  # 此代码来源于 qqwry-py3中
        return data[offset] + (data[offset + 1] << 8) + \
               (data[offset + 2] << 16)

    def __int4(self, data, offset):  # 此代码来源于 qqwry-py3中
        return data[offset] + (data[offset + 1] << 8) + \
               (data[offset + 2] << 16) + (data[offset + 3] << 24)

    def download_packages(self):
        get = requests.get(
            "https://mp.weixin.qq.com/mp/appmsgalbum?&action=getalbum&album_id=2329805780276838401#wechat_redirect")
        html = get.text
        findall = re.findall('''<script type="text/javascript">(.*?)</script>''', html, re.S)
        for tal in findall:
            b = re.findall("url: '(.*?)',", tal, re.S)
            for url in b:
                if url != '':
                    sub_html = requests.get(url).text
                    self.packages[re.findall("数据版本:(.*?)</span></p>", sub_html, re.S)[0][-8:]] = \
                        re.findall("下载地址:(.*?)</span>", sub_html, re.S)[0][9:]

        print("[#] Found packages versions")
        print(json.dumps(self.packages, indent=2))
        self.newest = max(self.packages.keys())
        print("[#] Download newest packages {0}".format(self.newest))
        content = requests.get(self.packages[self.newest]).content
        with open(f"./{self.newest}.zip", 'wb') as f:
            f.write(content)

    def extract_packages(self):
        print("[#] Unzip file {0}".format(self.newest))
        with zipfile.ZipFile(f"./{self.newest}.zip") as z:
            z.extractall("./release/")
        os.system("innoextract.exe -e release/setup.exe -d release/")

    def __get_addr(self, offset):
        mode = self.data[offset]
        if mode == 1:
            offset = self.__int3(self.data, offset + 1)
            mode = self.data[offset]
        if mode == 2:
            off1 = self.__int3(self.data, offset + 1)
            c = self.data[off1:self.data.index(b'\x00', off1)]
            offset += 4
        else:
            c = self.data[offset:self.data.index(b'\x00', offset)]
            offset += len(c) + 1
        if self.data[offset] == 2:
            offset = self.__int3(self.data, offset + 1)
        p = self.data[offset:self.data.index(b'\x00', offset)]
        return str(c.decode('gb18030', errors='replace')) + " " + str(p.decode('gb18030', errors='replace'))

    def __toip(self, hexip):
        return socket.inet_ntoa(struct.pack(">I", hexip))

    def extract_dat(self):
        with open(f"./release/app/qqwry.dat", 'rb') as f:
            self.data = f.read()
        index_begin = self.__int4(self.data, 0)
        index_end = self.__int4(self.data, 4)
        if index_begin > index_end or \
                (index_end - index_begin) % 7 != 0 or \
                index_end + 7 > len(self.data):
            self.__clear()
            return False
        self.index_begin = index_begin
        self.index_end = index_end
        self.index_count = (index_end - index_begin) // 7 + 1
        l = 0
        r = self.index_count
        rst = ""
        for m in range(l, r):  # 灵感来源于raw_search这个方法
            offset = self.index_begin + m * 7
            ip_begin = self.__int4(self.data, offset)
            offset = self.__int3(self.data, offset + 4)
            ip_end = self.__int4(self.data, offset)
            address = self.__get_addr(offset + 4)
            startip = self.__toip(ip_begin)
            endip = self.__toip(ip_end)
            startip_iton = ip_begin
            endip_iton = ip_end
            rst += f"""{address, startip, endip, startip_iton, endip_iton}\n"""
        with open("./ip.txt", 'w') as f:
            f.write(rst)

    def remove_temp(self):
        for root, dirs, files in os.walk('./release', topdown=False):
            for name in files:
                os.remove(os.path.join(root, name))
            for name in dirs:
                os.rmdir(os.path.join(root, name))
        os.removedirs("./release")

    def start(self):
        self.download_packages()
        self.extract_packages()
        self.extract_dat()
        self.remove_temp()


QQWryUtils().start()
截图
评论 0
还没有评论,来说点什么吧。