引言
警告
纯真库仅限个人开发者或学术研究使用,不能用于商业产品。
如本篇文章旨在学习python爬虫微信公众号,如果损害了您的利益,请联系站长,予以删除。
准备工作
- python
- re
- request
- uniextract
当然可以使用BeautifulSoup等包,也许会比本方法简单。
代码
import requests
import re
get = requests.get(
    "https://mp.weixin.qq.com/mp/appmsgalbum?&action=getalbum&album_id=2329805780276838401#wechat_redirect") # 这里是公众号的链接

html = get.text
findall = re.findall('''<script type="text/javascript">(.*?)</script>''', html,re.S)
for tal in findall:
    b = re.findall("url: '(.*?)',", tal, re.S)
    for url in b:
        if url != '':
            sub_html = requests.get(url).text
            print(re.findall("数据版本:(.*?)</span></p>",sub_html,re.S)[0][-8:],
                  re.findall("下载地址:(.*?)</span>",sub_html,re.S)[0][9:]) # 提取关键字
后续工作
解压zip文件,通过uniextract解压exe安装包,解析dat文件
截图
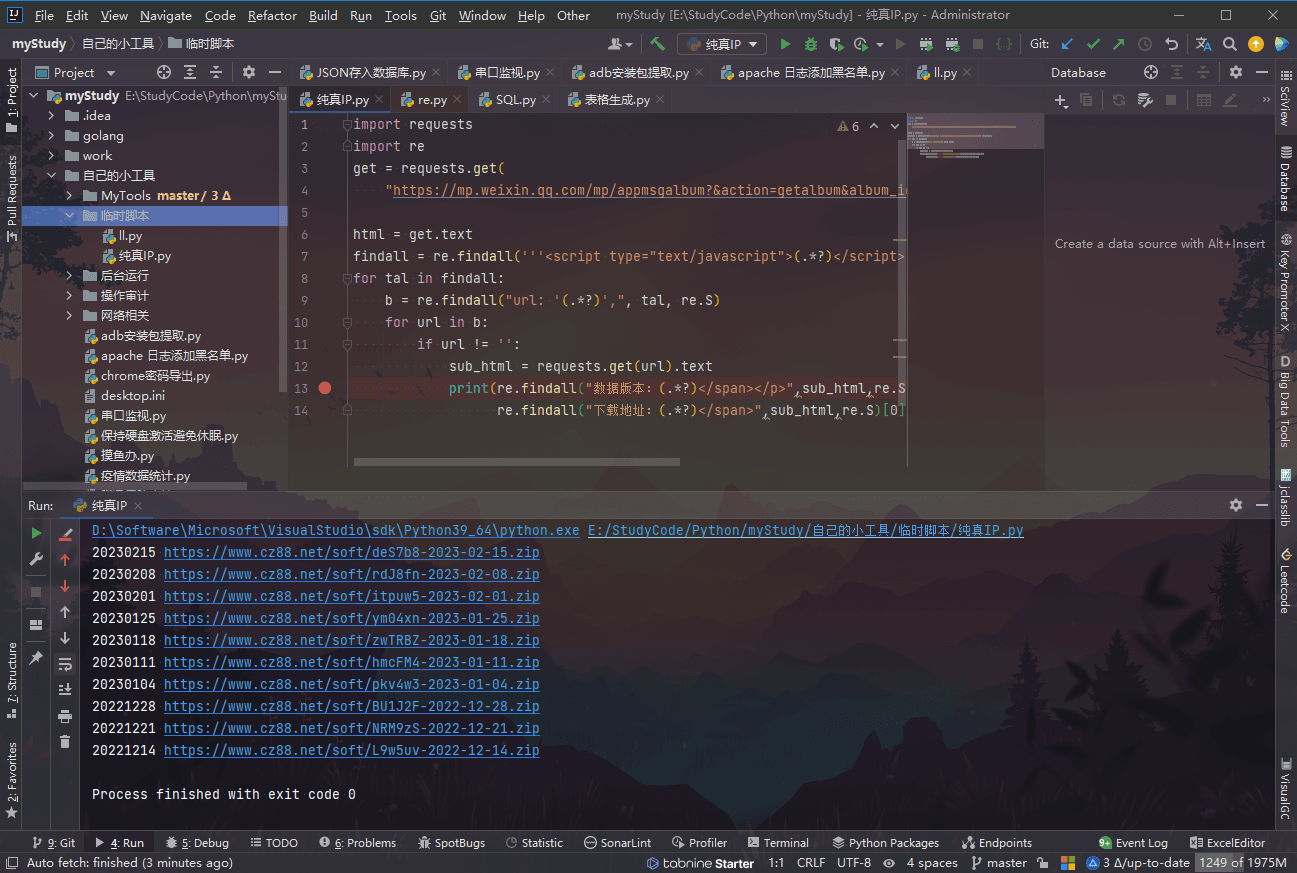
评论 0
还没有评论,来说点什么吧。