引言
开发一时爽,一直开发一直爽,但是到了写文档的时候,那就真的火葬场了,几百张表怎么写说明?不管是项目交接还是交付客户,有一张数据库表的说明是很重要的。因此自动化生成这个Excel是有必要的。
准备
安装特定环境
- python
- pandas
- pymysql
- openpyxl
按道理来说应该还有excel相关的依赖,缺啥补啥吧。
初版
import pymysql
import pandas as pd
import os

path = r'z:/excelFile/result.xlsx'
dbip = "127.0.0.1"
uname = "root"
psw = "root"
db = "your_database_name"


def listAllFiles(rootDir):
    files = []
    list = os.listdir(rootDir)
    for i in range(0, len(list)):
        path = os.path.join(rootDir, list[i])
        if os.path.isdir(path):
            files.extend(listAllFiles(path))
        if os.path.isfile(path):
            files.append(path)
    return files


conn = pymysql.connect(dbip, uname, psw, db)
cursor = conn.cursor()
cursor.execute("show tables;")
resultSet = cursor.fetchall()
now = 0  # 计数器
with pd.ExcelWriter(path) as xlsx:
    for i in resultSet:  # 遍历数据表
        now += 1
        sql = """SELECT
        ORDINAL_POSITION AS 序号,
        COLUMN_NAME 列名,
        COLUMN_COMMENT 列说明,
        DATA_TYPE 数据类型,
        CHARACTER_MAXIMUM_LENGTH AS 长度,
        NUMERIC_SCALE AS 小数位数,
        (
            CASE
            WHEN column_key = 'PRI' THEN
                '√'
            ELSE
                ''
            END
        ) AS 主键,
        (
            CASE
            WHEN is_nullable = 'NO' THEN
                ''
            ELSE
                '√'
            END
        ) AS 允许空,
        COLUMN_DEFAULT 默认值
    FROM
        INFORMATION_SCHEMA. COLUMNS
    WHERE
        table_schema = '{0}'
    AND table_name = '{1}'""".format(db, i[0])

        print("task:index table\t" + "current:" + str(now) + "\t" + "total:" + str(
            len(resultSet)) + "\t" + "%:" + str((now / len(resultSet)) * 100)[0:6] + "%")
        data = pd.read_sql_query(sql=sql, con=conn, index_col=None)
        data = data.sort_values(by="序号", axis=0)  # 保证顺序和sql输出的顺序一致
        data.to_excel(xlsx, sheet_name=i[0], index=None, startrow=0)

print("task:successfully")
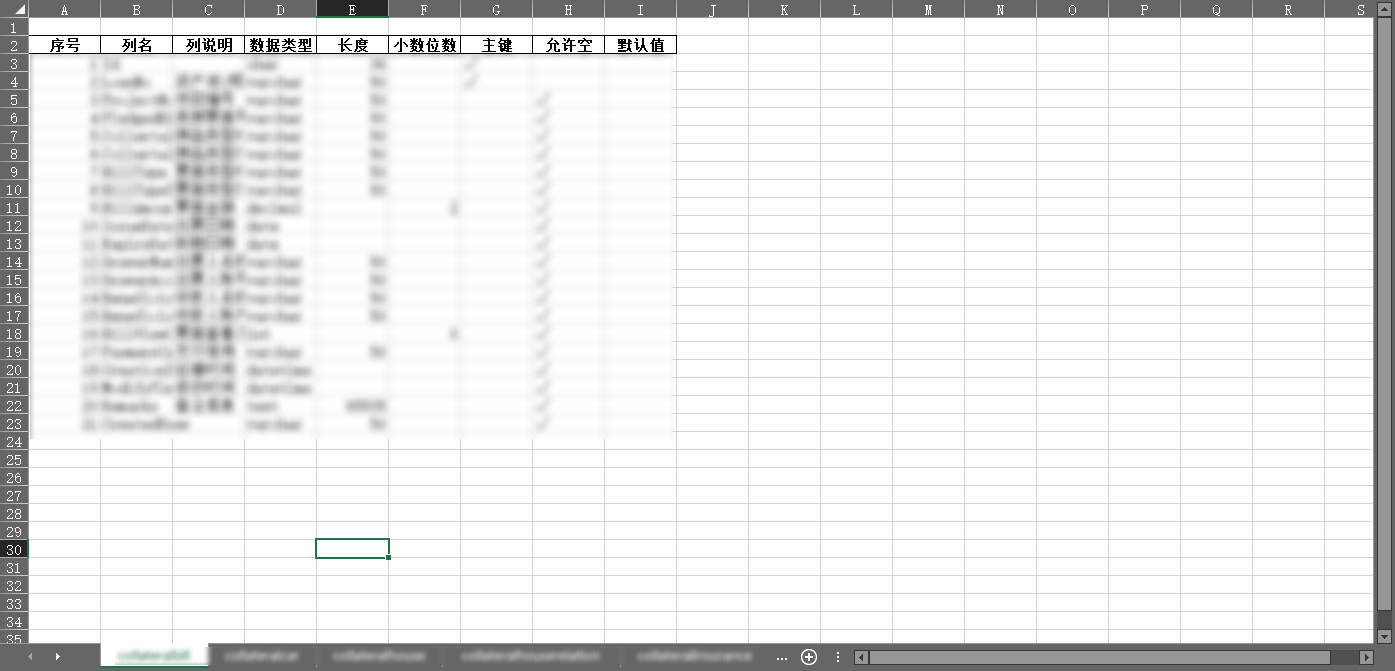
效果图
进阶
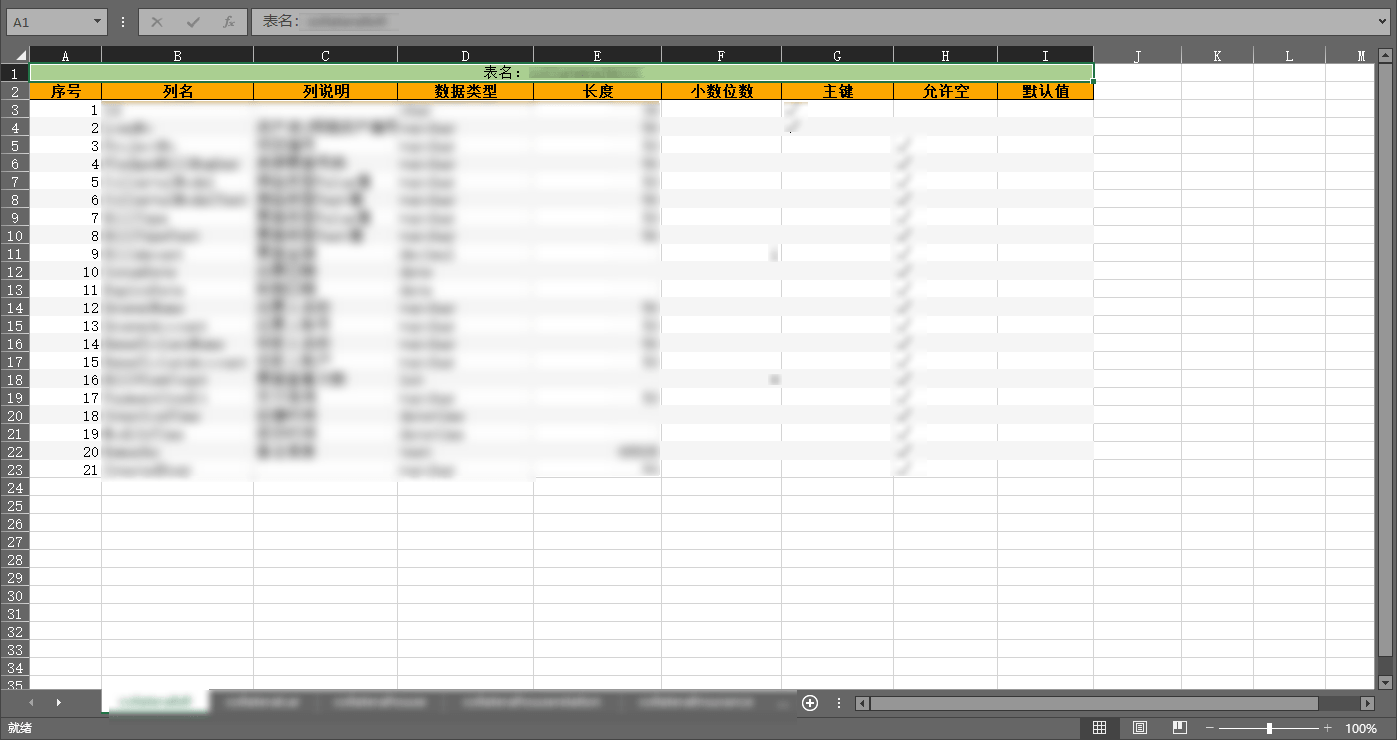
因为pandas不是很熟,所以采用了openpyxl来添加表头,并且间隔行不同颜色,加上样式,提高了用户体验。
import pymysql
import pandas as pd
import os
import xlwt
import openpyxl
from openpyxl.styles import Alignment
from openpyxl import Workbook
from openpyxl.styles import PatternFill

path = r'z:/excelFile/result.xlsx'
dbip = "127.0.0.1"
uname = "root"
psw = "root"
db = "your_database_name"
sheetList = []


def listAllFiles(rootDir):
    files = []
    list = os.listdir(rootDir)
    for i in range(0, len(list)):
        path = os.path.join(rootDir, list[i])
        if os.path.isdir(path):
            files.extend(listAllFiles(path))
        if os.path.isfile(path):
            files.append(path)
    return files


conn = pymysql.connect(dbip, uname, psw, db)
cursor = conn.cursor()
cursor.execute("show tables;")
resultSet = cursor.fetchall()
now = 0  # 计数器

with pd.ExcelWriter(path) as xlsx:
    for i in resultSet:  # 遍历数据表
        now += 1
        sql = """SELECT
        ORDINAL_POSITION AS 序号,
        COLUMN_NAME 列名,
        COLUMN_COMMENT 列说明,
        DATA_TYPE 数据类型,
        CHARACTER_MAXIMUM_LENGTH AS 长度,
        NUMERIC_SCALE AS 小数位数,
        (
            CASE
            WHEN column_key = 'PRI' THEN
                '√'
            ELSE
                ''
            END
        ) AS 主键,
        (
            CASE
            WHEN is_nullable = 'NO' THEN
                ''
            ELSE
                '√'
            END
        ) AS 允许空,
        COLUMN_DEFAULT 默认值
    FROM
        INFORMATION_SCHEMA. COLUMNS
    WHERE
        table_schema = '{0}'
    AND table_name = '{1}'""".format(db, i[0])
        # print(sql)
        print("task:index table:" + i[0] + "\t" + "current:" + str(now) + "\t" + "total:" + str(
            len(resultSet)) + "\t" + "%:" + str((now / len(resultSet)) * 100)[0:6] + "%")
        if i[0].find("_tmp") > 0 or i[0].find("_copy1") > 0 or i[0].find("_122") > 0:
            print("pass:" + i[0])
            continue
        sheetList.append(i[0])
        data = pd.read_sql_query(sql=sql, con=conn, index_col=None)
        data = data.sort_values(by="序号", axis=0)  # 保证顺序和sql输出的顺序一致
        data.to_excel(xlsx, sheet_name=i[0], index=None, startrow=1)


print("task:prepare insert header data")
workbook = openpyxl.load_workbook(path)
names = workbook.sheetnames
now = 0
for i in names:
    now += 1
    print("task:change sheet style:" + i + "\t" + "current:" + str(now) + "\t" + "total:" + str(
        len(names)) + "\t" + "%:" + str((now / len(names)) * 100)[0:6] + "%")
    sheet = workbook[i]
    cell = sheet.cell(1, 1, "表名:" + i)
    sheet.merge_cells("A1:I1")
    cell.alignment = Alignment(horizontal='center', vertical='center')
    cell.fill = PatternFill(fill_type="solid", fgColor="AACF91")
    row = sheet.max_row
    for j in range(1, 10):
        cell = sheet.cell(2, j)
        sheet.column_dimensions[chr(ord('A') + j)].width = 20 - j
        cell.fill = PatternFill(fill_type="solid", fgColor="fca700")
    for j in range(3, row + 1):
        for k in range(1, 10):
            cell = sheet.cell(j, k)
            if j % 2 == 0:
                cell.fill = PatternFill(fill_type="solid", fgColor="f5f5f5")

workbook.save(path)
print("task:successfully")
效果图
终版
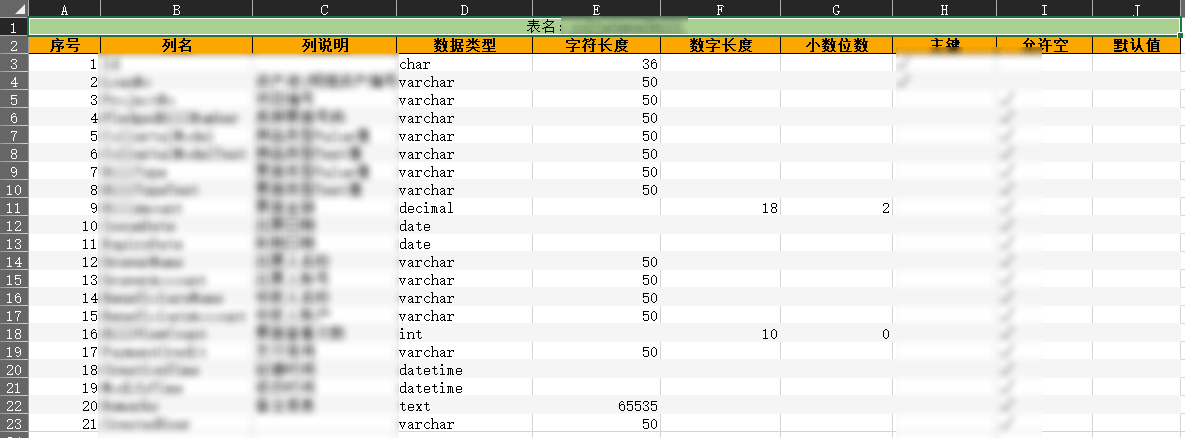
金融行业需要显示数字类型长度,因此可以使用下面的代码。
import pymysql
import pandas as pd
import os
import xlwt
import openpyxl
from openpyxl.styles import Alignment
from openpyxl import Workbook
from openpyxl.styles import PatternFill

path = r'z:/excelFile/result.xlsx'
dbip = "127.0.0.1"
uname = "root"
psw = "root"
db = "your_databases_name"
sheetList = []


def listAllFiles(rootDir):
    files = []
    list = os.listdir(rootDir)
    for i in range(0, len(list)):
        path = os.path.join(rootDir, list[i])
        if os.path.isdir(path):
            files.extend(listAllFiles(path))
        if os.path.isfile(path):
            files.append(path)
    return files


conn = pymysql.connect(dbip, uname, psw, db)
cursor = conn.cursor()
cursor.execute("show tables;")
resultSet = cursor.fetchall()
now = 0  # 计数器

with pd.ExcelWriter(path) as xlsx:
    for i in resultSet:  # 遍历数据表
        now += 1
        sql = """SELECT
        ORDINAL_POSITION AS 序号,
        COLUMN_NAME 列名,
        COLUMN_COMMENT 列说明,
        DATA_TYPE 数据类型,
        CHARACTER_MAXIMUM_LENGTH AS 字符长度,
        NUMERIC_PRECISION AS 数字长度,
        NUMERIC_SCALE AS 小数位数,
        (
            CASE
            WHEN column_key = 'PRI' THEN
                '√'
            ELSE
                ''
            END
        ) AS 主键,
        (
            CASE
            WHEN is_nullable = 'NO' THEN
                ''
            ELSE
                '√'
            END
        ) AS 允许空,
        COLUMN_DEFAULT 默认值
    FROM
        INFORMATION_SCHEMA. COLUMNS
    WHERE
        table_schema = '{0}'
    AND table_name = '{1}'""".format(db, i[0])
        # print(sql)
        print("task:index table:" + i[0] + "\t" + "current:" + str(now) + "\t" + "total:" + str(
            len(resultSet)) + "\t" + "%:" + str((now / len(resultSet)) * 100)[0:6] + "%")
        if i[0].find("_tmp") > 0 or i[0].find("_copy1") > 0 or i[0].find("_122") > 0:
            print("pass:" + i[0])
            continue
        sheetList.append(i[0])
        data = pd.read_sql_query(sql=sql, con=conn, index_col=None)
        data = data.sort_values(by="序号", axis=0)  # 保证顺序和sql输出的顺序一致
        data.to_excel(xlsx, sheet_name=i[0], index=None, startrow=1)


print("task:prepare insert header data")
workbook = openpyxl.load_workbook(path)
names = workbook.sheetnames
now = 0
for i in names:
    now += 1
    print("task:change sheet style:" + i + "\t" + "current:" + str(now) + "\t" + "total:" + str(
        len(names)) + "\t" + "%:" + str((now / len(names)) * 100)[0:6] + "%")
    sheet = workbook[i]
    cell = sheet.cell(1, 1, "表名:" + i)
    sheet.merge_cells("A1:J1")
    cell.alignment = Alignment(horizontal='center', vertical='center')
    cell.fill = PatternFill(fill_type="solid", fgColor="AACF91")
    row = sheet.max_row
    for j in range(1, 11):
        cell = sheet.cell(2, j)
        sheet.column_dimensions[chr(ord('A') + j)].width = 20 - j
        cell.fill = PatternFill(fill_type="solid", fgColor="fca700")
    for j in range(3, row + 1):
        for k in range(1, 11):
            cell = sheet.cell(j, k)
            if j % 2 == 0:
                cell.fill = PatternFill(fill_type="solid", fgColor="f5f5f5")


workbook.save(path)
print("task:successfully")
效果图
评论 0
还没有评论,来说点什么吧。